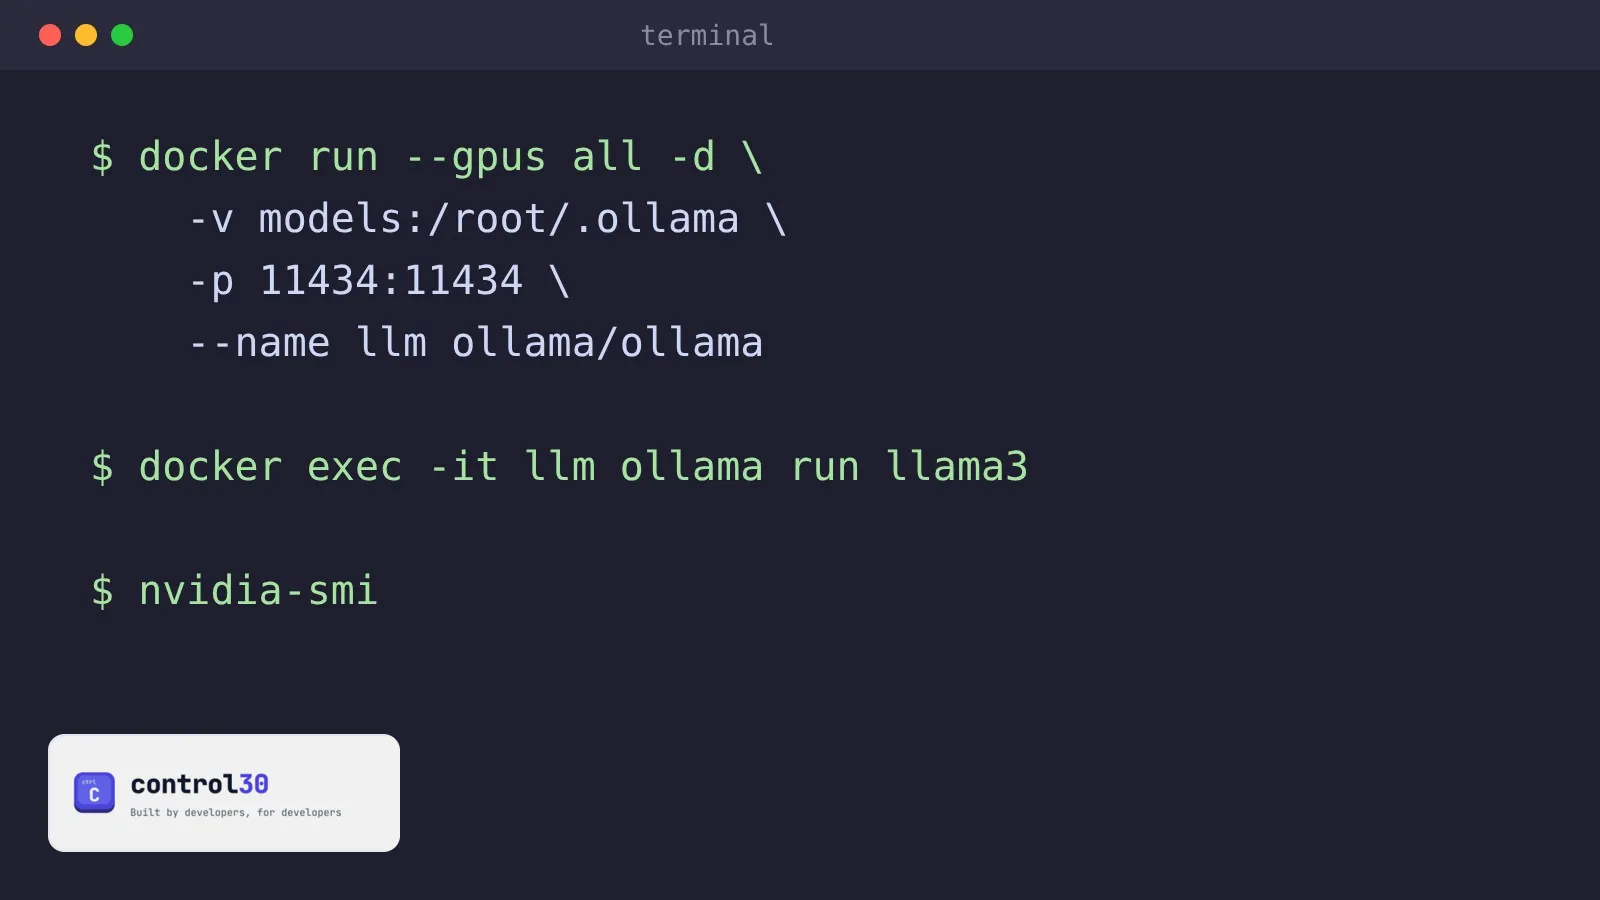
اجرای مدل زبانی با Docker باعث میشود محیط شما تکرارپذیر، قابلانتقال و ایزوله باشد؛ بهخصوص وقتی از GPU استفاده میکنید.
پیشنیازها
درایور انویدیا و بستهی NVIDIA Container Toolkit باید روی میزبان نصب باشند تا کانتینر به GPU دسترسی داشته باشد. با دستور nvidia-smi درستی نصب را بررسی کنید.
حجمها برای مدلها
مدلها حجم زیادی دارند؛ آنها را در یک Volume ذخیره کنید تا با حذف کانتینر دوباره دانلود نشوند.
امنیت و مانیتورینگ
پورت API را فقط روی شبکهی داخلی باز کنید، منابع مصرفی را محدود کنید و GPU و حافظه را با ابزارهایی مانند Prometheus و DCGM پایش کنید.
جمعبندی
با Docker میتوانید یک سرویس LLM محلی را در چند دقیقه روی هر سرور GPUدار راه بیندازید.
منابع: مستندات Docker، NVIDIA